Hodina 08 · 90 minut · 13 částí
Umělá inteligence
Jak jazykové modely fungují (tokeny, pravděpodobnost, kontext), kdo je vyrábí, co stojí a jak je v marketingu používat každý den: text, obraz, video, zvuk a agenti, kteří pracují sami.
Co si odnesete
- -Vysvětlit vlastními slovy, co model dělá, když píše: tokeny, pravděpodobnost dalšího tokenu, kontextové okno, trénink vs. inference.
- -Orientovat se v hráčích a vrstvách: čipy, datacentra, API, frontier modely vs. open-weights, chat vs. API.
- -Napsat prompt, který dá použitelný výstup napoprvé, a vědět, co po modelu zkontrolovat.
- -Vybrat nástroj pro text, obraz, video, zvuk a přepis a odhadnout, co to bude stát.
- -Chápat, co je agent a MCP, a na příkladu velínu vidět, jak AI třídí zprávy za 0,25 $ denně.
- -Znát rizika (deepfakes, halucinace, soukromí) a povinnosti podle EU AI Act od srpna 2026.
Plán hodiny
- 5 minÚvod a otázka do třídy · Kdy jste dnes použili AI a nevšimli si toho?
- 5 minPrezentace studenta · Ukažte jeden nástroj s AI, který jste použili ke škole nebo v práci: na co, co se povedlo, co pokazil a kolik stál.
- 15 minProč teď a technologická vrstva · Od Turinga k ChatGPT, čtyři faktory boomu, čipy, datacentra, energie, API.
- 13 minJak to funguje a kdo je kdo · Tokenizer naživo, pravděpodobnost, trénink vs. inference, slovník, frontier vs. open-weights.
- 6 minText a prompting · Pět tříd použití, krátký vs. plný prompt naživo, co kontroluju v PR balíčku.
- 10 minCvičení: prompt na nábor dětí do juda · Každý napíše vlastní prompt na stejné zadání (vzor je v rámečku AI v praxi), vymění výstup se sousedem a prompt opraví. Tři iterace za deset minut.
- 11 minObraz, video, zvuk a přepis · Bestiář a jednotný styl, 30 sekund Hell Grind, přepis a citace z nahrávky.
- 11 minAgenti, velín a ceny · Agent, MCP, Claude Code, workflow s více agenty, velín jako síto, tokeny a cache.
- 9 minRizika, regulace a AI v marketingu · Deepfakes, halucinace, EU AI Act, co bude vzácné, checklist po oborech.
- 5 minShrnutí a kvíz · Pět otázek, tři věty na cestu.
Obsah
- 1Od Turinga k ChatGPT: 72 let příprav
- 2Proč boom přišel až teď
- 3Technologická vrstva: čipy, datacentra, cloud, API
- 4Jak to funguje: tokeny a pravděpodobnost
- 5Kdo je kdo: frontier modely a open-weights
- 6Text na text a prompting prakticky
- 7Obraz: z promptu vizuál
- 8Video, zvuk a přepis
- 9Agenti, MCP a Claude Code
- 10Velín: AI jako síto zpráv
- 11Co to stojí: tokeny, cache, dávky
- 12Rizika, regulace a co bude vzácné
- 13AI v marketingu: kde začít zítra
1Od Turinga k ChatGPT: 72 let příprav
0:00 / 1:43AI klon hlasu Jana Ječmínka
AI není nápad z roku 2022
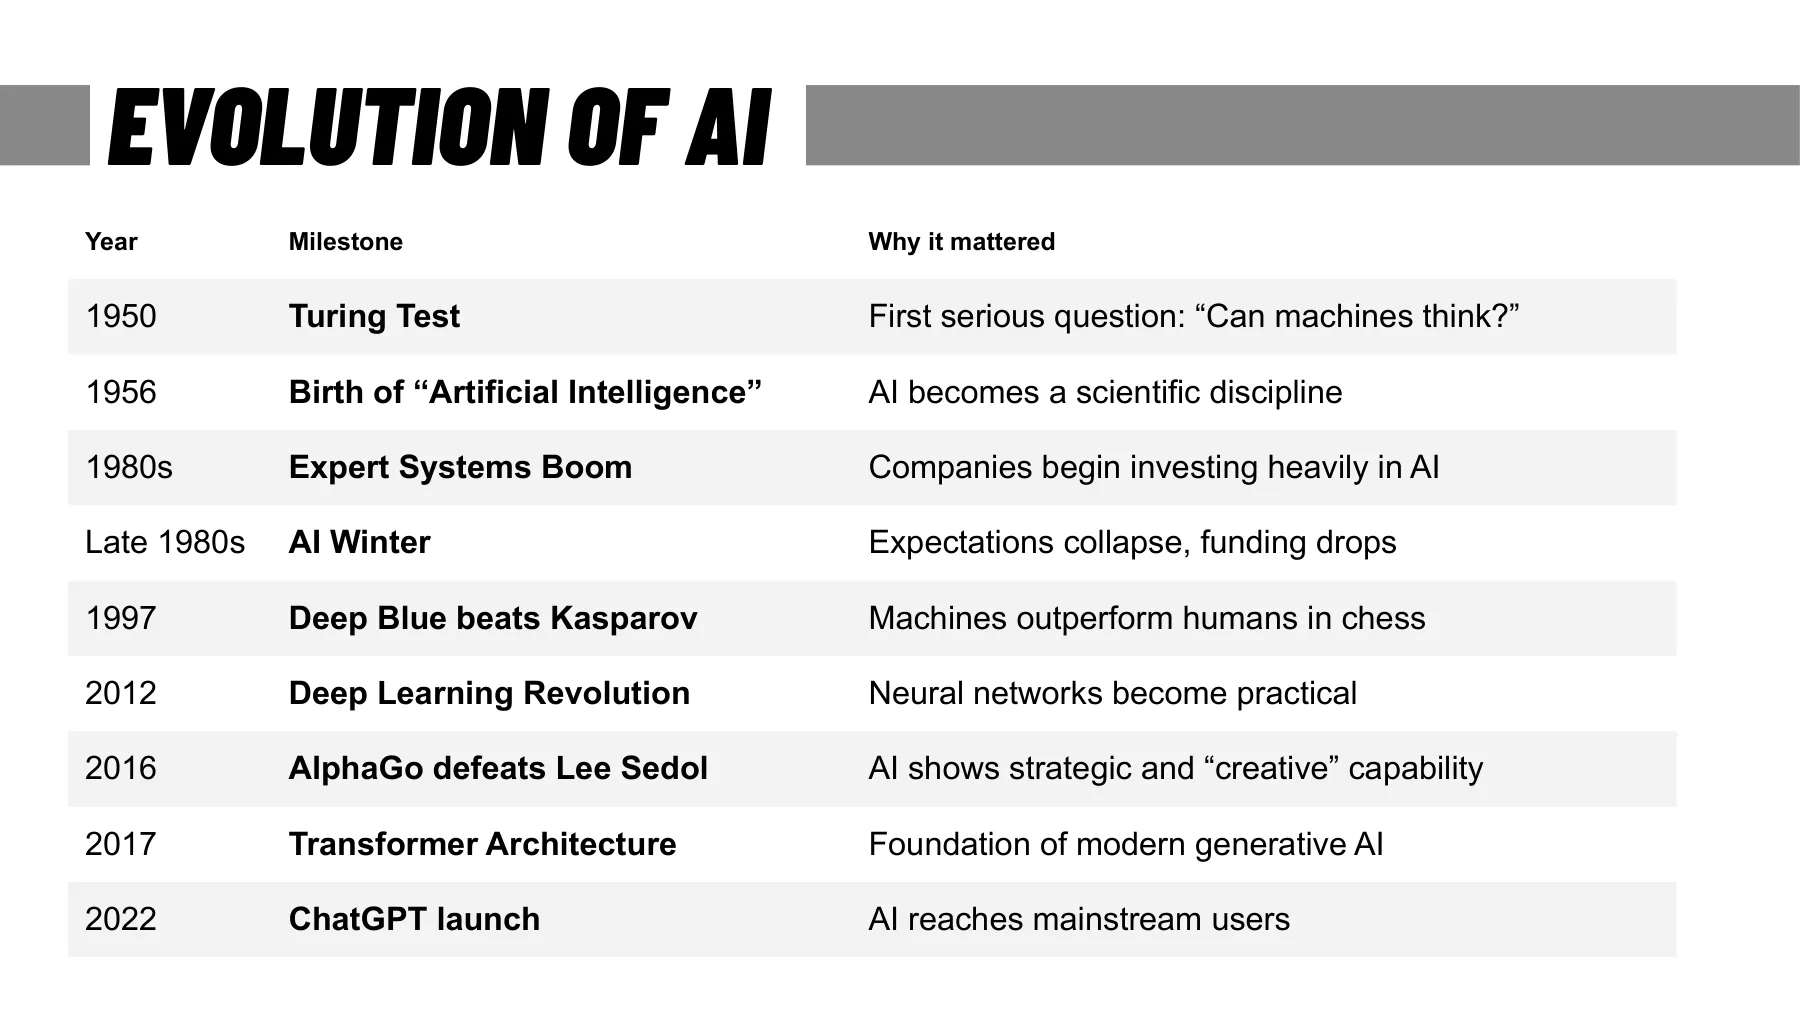
- ·1950 Turing: „Can machines think?“ · 1956 Dartmouth: pojem AI
- ·1997 Deep Blue · 2012 deep learning · 2016 AlphaGo · 2017 Transformer
- ·30. 11. 2022 ChatGPT: AI má poprvé masové publikum
- ·Vlny: hype, zima, hype. Marketér musí poznat, kde zrovna jsme
Obor je starší než většina vašich rodičů. Alan Turing v roce 1950 v článku Computing Machinery and Intelligence položil otázku, jestli stroje mohou myslet, a místo definice navrhl hru: pokud nepoznáte, jestli si píšete s člověkem nebo se strojem, je spor o „myšlení“ zbytečný. Dnes tomu říkáme Turingův test. V roce 1956 dostal v Dartmouthu jméno artificial intelligence.
Pak přišly vlny. V 80. letech firmy investovaly do expertních systémů (ručně psaná pravidla), koncem dekády přišla „AI zima“ (AI winter): zmizely peníze i zájem. V roce 1997 porazil Deep Blue od IBM Kasparova v šachu, v roce 2012 udělaly grafické karty z neuronových sítí použitelný nástroj (deep learning) a v roce 2016 AlphaGo porazil Lee Sedola v go, hře, kterou měly stroje zvládnout „až za desítky let“.
Dva klíčové roky pro to, co máte dnes v telefonu: 2017, kdy Google publikoval architekturu Transformer (Attention Is All You Need), na které stojí GPT, Claude i Gemini, a 30. listopad 2022, kdy OpenAI spustila ChatGPT. Technologie existovala dřív, ale teprve chatovací okno ji dalo stovkám milionů lidí bez návodu.
Část toho, co dnes slyšíte, je bublina, část infrastruktura na dalších dvacet let, jako internet kolem roku 2000. Popkultura vás připravila na robota zabijáka, ne na asistenta, který vám přepíše schůzku; s tím očekáváním v komunikaci pracujete.
K diskuzi
Který film nebo seriál vám jako první ukázal umělou inteligenci? A v čem se liší od toho, co dnes máte v telefonu?
Králičí nory
- Turing: Computing Machinery and Intelligence (1950), PDF ↗ · Původní článek z časopisu Mind (doi 10.1093/mind/LIX.236.433) jako volná kopie z kurzu McGill. Čte se dodnes dobře.
- IBM: Deep Blue ↗ · Jak vypadal stroj, který v roce 1997 porazil Kasparova.
- AlphaGo: The Movie ↗ · Dokument DeepMindu o zápasu s Lee Sedolem, 90 minut napětí.
2Proč boom přišel až teď
0:00 / 2:01AI klon hlasu Jana Ječmínka
Čtyři faktory, žádný sám nestačil
- ·Výpočetní výkon: GPU a specializované čipy
- ·Data z internetu: text, obrázky, kód v bilionech tokenů
- ·Transformer (2017): umí kontext a jde paralelizovat
- ·Cloud a API: nemusíte mít datacentrum, stačí klíč
Proč zrovna teď a ne v roce 2010? Sešly se čtyři věci, z nichž žádná sama nestačila. Výkon: grafické karty (GPU, hlavně od Nvidie) násobí matice paralelně, a trénink modelu je právě to. Data: internet dal biliony slov, obrázků a kódu, ze kterých se model učí vzorce. Transformer: architektura z roku 2017 s mechanismem pozornosti (attention) váží souvislosti napříč dlouhým textem a trénuje se paralelně, takže GPU využije naplno. Cloud a API: model běží u výrobce, vy platíte za použití.
Rychlost přijetí nemá obdobu. ChatGPT měl milion uživatelů za 5 dní a podle odhadu banky UBS 100 milionů za 2 měsíce. V únoru 2026 hlásila OpenAI 900 milionů týdně aktivních uživatelů a 50 milionů platících. Stanfordský AI Index 2026 spočítal, že generativní AI dosáhla 53 % populace do tří let, rychleji než osobní počítač nebo internet (srovnání médií v kapitole Média).
Česká čísla se letos rychle mění. V roce 2025 používalo podle ČSÚ nějakou technologii AI 18 % podniků s 10 a více zaměstnanci, průměr EU byl 20 %. V první polovině roku 2026 to bylo už 35 %, dvakrát víc; jak si za letošek stojí ostatní země EU, zveřejní ČSÚ v lednu 2027. Rozhoduje velikost: AI používá 30 % malých firem do 49 zaměstnanců, polovina středních a 74 % velkých s 250 a více zaměstnanci. A obor, jak ukazují tabulky ČSÚ: v IT 85 %, ve vydavatelstvích, vysílání a tvorbě obsahu 74 %, v odborných službách, kam patří i reklamní agentury, 58 %, ve stavebnictví 18 %. Nejčastěji s ní firmy píšou texty a kód nebo vytvářejí hlas, to dělá 31 % z nich; zhruba pětina tvoří obrázky, video nebo hudbu.
U lidí je Česko nad evropským průměrem. Generativní AI podle ČSÚ v roce 2025 používalo 32 % Čechů od 16 let a 78 % ve věku 16 až 24 let. Ve srovnání Eurostatu pro věk 16 až 74 let má Česko 35 % a EU 33 %, u mladých je rozdíl větší: 78 % proti 64 %. Liší se účel. Ke studiu ji použilo 59 % mladých Čechů a 41 % mladých Evropanů, k práci ale jen 14 % Čechů, o něco méně než v EU, kde to bylo 15 %. Rozhoduje i vzdělání: v produktivním věku používá AI 60 % vysokoškoláků a 16 % lidí se základním vzděláním. Ve světovém srovnání Microsoftu za 2. čtvrtletí 2026 je Česko s 31 % lidí ve věku 15 až 64 let nad průměrem 19 %, ale daleko za Spojenými arabskými emiráty se 73 % a Singapurem se 64 %. Ve třídě jste tedy nejspíš napřed před většinou firem, do kterých půjdete.
- 100 mil.
- uživatelů ChatGPT za 2 měsíce od spuštění (odhad)
- 900 mil.
- týdně aktivních uživatelů ChatGPT, únor 2026
- 53 %
- populace používá generativní AI do 3 let od startu
- 35 %
- českých podniků 10+ používalo AI v 1. pololetí 2026, rok předtím 18 %
UBS / Reuters, 2/2023
OpenAI via TechCrunch
Stanford AI Index 2026
ČSÚ, 11/2026

Králičí nory
- Attention Is All You Need (2017) ↗ · Článek, na kterém stojí GPT, Claude i Gemini. Aspoň abstrakt a obrázek 1.
- TechCrunch: ChatGPT má 900 milionů týdenních uživatelů ↗ · Čísla z února 2026 včetně 50 milionů platících.
- ČSÚ: ICT v podnicích ↗ · Oficiální česká čísla za rok 2026: AI používá 35 % podniků s 10+ zaměstnanci; tabulky podle velikosti firem a oborů.
- Microsoft: Global AI Diffusion, 2. čtvrtletí 2026 (PDF) ↗ · Kolik lidí ve věku 15 až 64 let používá AI v jednotlivých zemích. Žebříček se vydává každé čtvrtletí, data jsou volně ke stažení.
3Technologická vrstva: čipy, datacentra, cloud, API
0:00 / 2:33AI klon hlasu Jana Ječmínka
Chat je jen špička: v ceně tokenu platíte čipy, haly i elektřinu
- ·Čipy (Nvidia GPU, Google TPU) → datacentra → cloud a API → aplikace
- ·Nvidia: první firma za 5 bil. $ (říjen 2025)
- ·Datacentra: 415 TWh v roce 2024, 945 TWh v roce 2030 (IEA)
- ·Jeden dotaz: zhruba 0,24 Wh, mikrovlnka na jednu sekundu
Pod chatovacím oknem jsou čtyři vrstvy. Dole čipy: GPU Nvidia a specializované čipy jako Google TPU. Nad nimi datacentra, haly s desítkami tisíc čipů, chlazením a přívodem elektřiny; staví je Microsoft, Google, Amazon, Meta a OpenAI s partnery (Stargate). Nad tím cloud a API: Anthropic, OpenAI nebo Google model provozují a vy ho voláte. Nahoře aplikace: ChatGPT, Claude, Gemini, nebo váš web, který API zavolá. Marketér pracuje v horní vrstvě, ale v ceně tokenu platí všechny čtyři.
Nvidia se 29. října 2025 stala první firmou s tržní hodnotou 5 bilionů dolarů; 4 biliony překročila necelé čtyři měsíce předtím. Čtyři největší provozovatelé datacenter investovali v roce 2025 zhruba 410 mld. $ a na rok 2026 podle výhledů míří k odhadovaným 700 mld. $, většinou do AI infrastruktury.
Druhá cena je elektřina. Podle IEA spotřebovala datacentra v roce 2024 415 TWh, zhruba 1,5 % světové elektřiny, a od roku 2017 rostou 12 % ročně, čtyřikrát rychleji než celková spotřeba. Do roku 2030 čeká IEA zdvojnásobení na 945 TWh, víc než dnes spotřebuje celé Japonsko. Jeden dotaz je přitom drobnost: Google změřil medián textového dotazu v Gemini na 0,24 Wh (mikrovlnka na jednu sekundu, pět kapek vody), Sam Altman uvádí u ChatGPT 0,34 Wh. Problém jsou miliardy dotazů a trénink. Vy přes API kupujete službu, ne technologii, jako u platební brány (kapitola Internet).
- 5 bil. $
- tržní hodnota Nvidie, první firma na světě (29. 10. 2025)
- ~700 mld. $
- odhad investic Amazonu, Microsoftu, Alphabetu a Mety v roce 2026
- 0,24 Wh
- medián spotřeby jednoho textového dotazu v Gemini
AP, 10/2025
Yahoo Finance, 5/2026
Google / MIT Technology Review
Spotřeba elektřiny datacenter ve světě (TWh)
v jednotkách: TWh
V roce 2024 to bylo 1,5 % světové elektřiny; v roce 2030 víc, než dnes spotřebuje Japonsko. Roky 2030 a 2035 jsou základní scénář IEA.
data v tabulce
| 2024 | 415 TWh | |
|---|---|---|
| 2030 | 945 TWh | projekce |
| 2035 | 1 200 TWh | projekce |
4Jak to funguje: tokeny a pravděpodobnost
0:00 / 3:42AI klon hlasu Jana Ječmínka
Model hádá další token. Pořád dokola
- ·Text → tokeny (zhruba 3,5 znaku anglicky), každý má číslo
- ·Model spočítá pravděpodobnost dalšího tokenu, vybere, přidá, opakuje
- ·Trénink jednou a draho; inference pokaždé, když se ptáte
- ·Kontextové okno = pracovní paměť: dnes až 1 mil. tokenů
- ·Halucinace: optimalizuje věrohodnost, ne pravdu
Velký jazykový model (LLM) je statistický model jazyka. Text se nejdřív rozseká na tokeny: kusy slov, u angličtiny zhruba 3,5 znaku na token, u češtiny s diakritikou a skloňováním víc kousků na slovo. Každý token má číslo. Model spočítá pro všechny tokeny ve slovníku pravděpodobnost, že budou následovat, jeden vybere, přidá na konec a zopakuje to. Nic víc. Že z toho vzniká článek, kód nebo básnička, je důsledek miliard parametrů, v nichž jsou zakódované vzorce z bilionů slov, na kterých se model učil.
Rozlišujte trénink a inferenci. Trénink probíhá jednou: předtrénování (pretraining) na obrovském korpusu s jediným úkolem, předpovědět další slovo; pak dolaďování (fine-tuning) a učení z lidské zpětné vazby (RLHF), aby model odpovídal jako asistent, ne jako náhodná stránka z internetu. Stojí to měsíce na tisících GPU. Inference je každý váš dotaz: levná na jedno volání, drahá v masovém měřítku. A hlavně: model je po tréninku zmrazený, z vaší konverzace se nic nenaučí, pokud aplikace nemá zvlášť postavenou paměť.
Kontextové okno je pracovní paměť: kolik tokenů model naráz „vidí“, tedy prompt, přiložené dokumenty i vlastní odpověď. Claude i Gemini nabízejí okno 1 milionu tokenů. Milion tokenů je zhruba 2 000 stran textu (odhad). Co se do okna nevejde, model nezná.
Teplota (temperature) řídí náhodnost výběru: nula dává nejpravděpodobnější a nejnudnější text, vyšší hodnota překvapivější, ale méně spolehlivý. Odtud nejdůležitější vlastnost pro marketéra: halucinace. Model optimalizuje věrohodnost, ne pravdivost; vymyšlená studie nebo špatné číslo vypadají stejně sebejistě jako správná odpověď. Proto každé jméno, číslo a odkaz ověřujete vy. A čeština platí navíc: víc tokenů na slovo, vyšší cena, méně textu v okně. Slovník pojmů je níže.
- -LLM: velký jazykový model, jádro generativní AI. Předpovídá další token.
- -Prompt: instrukce pro model. Systémový nastavuje roli a pravidla, uživatelský zadává úkol.
- -Token: kousek textu, jednotka, za kterou platíte.
- -Kontextové okno: kolik tokenů model naráz vidí.
- -Teplota: míra náhodnosti výběru tokenu. Nula = předvídatelné, vyšší = kreativnější i chybovější.
- -Halucinace: sebejistá, ale nepravdivá odpověď. Vypadá jako pravda.
- -Fine-tuning: dotrénování modelu na vlastních datech. Drahé, v marketingu potřeba málokdy.
- -RAG: před odpovědí vyhledej v dokumentech, co je relevantní, a vlož to do promptu. Základ firemních chatbotů.
- -Multimodalita: model zpracuje i vytvoří text, obraz, zvuk, video.
- -Agent: model se smyčkou a nástroji. Plánuje, volá nástroje, vykonává, vyhodnocuje.
- -MCP: standard, jak model připojit k datům a nástrojům. „USB-C pro AI“.
- -Open-weights: model se zveřejněnými váhami, který provozujete sami.
- ~3,5 znaku
- jeden token anglického textu u starších modelů Claude
- 1 mil.
- tokenů v kontextovém okně Claude i Gemini
Anthropic, glosář
Anthropic, Google

K diskuzi
Proč model raději vymyslí citaci, než aby napsal „nevím“? A co z toho plyne pro každý text, který od něj převezmete?
Králičí nory
- Anthropic: glosář ↗ · Token, kontextové okno, teplota, RAG, RLHF na jedné stránce.
- 3Blue1Brown: But what is a GPT? ↗ · Vizuální vysvětlení, které pochopí i humanitní obor.
- OpenAI Tokenizer ↗ · Hřiště na tokeny. Zkuste češtinu.
5Kdo je kdo: frontier modely a open-weights
0:00 / 2:11AI klon hlasu Jana Ječmínka
Čtyři laboratoře, dva tábory, tři způsoby přístupu
- ·Frontier: Anthropic (Claude), OpenAI (GPT), Google (Gemini), xAI (Grok)
- ·Open-weights: Meta Llama, Mistral, DeepSeek, Qwen, gpt-oss
- ·Chat (20 $/měs) · API (za tokeny) · vlastní provoz (open-weights)
- ·USA 285,9 mld. $ investic vs. Čína 12,4 mld. $, rozdíl ve výkonu 2,7 %
- ·Česky: BenCzechMark a EuroEval, nahoře GPT, Gemini i otevřený GLM
Na špičce (frontier) je hrstka laboratoří: Anthropic (Claude), OpenAI (GPT), Google DeepMind (Gemini) a xAI (Grok). Jejich modely dostanete jen přes aplikaci nebo API, váhy (naučené parametry) jsou tajné. Druhý tábor jsou open-weights modely: Meta (Llama), francouzský Mistral, čínské DeepSeek, Qwen nebo Kimi, nověji i gpt-oss od OpenAI. Váhy si stáhnete a provozujete sami. Pozor na slovo „open source“: otevřené jsou váhy, ne tréninková data ani postup.
Tři způsoby přístupu. Chatovací aplikace (Claude, ChatGPT, Gemini) jsou pro lidi: plán Pro stojí u Claude 20 $ měsíčně, při roční platbě 17 $ měsíčně, Max od 100 $ (claude.com/pricing, říjen 2026). API je pro automatizaci: platíte za tokeny, model je součástí vašeho webu nebo skriptu. Vlastní provoz open-weights modelu dává kontrolu nad daty, ale platíte servery a lidi. Pro marketingový tým: aplikace pro lidi, API pro procesy, vlastní provoz jen s dobrým důvodem.
Modely se liší charakterem víc než čísly v žebříčcích; žebříčky se mění každý měsíc, takže je lepší mít dva tři modely v ruce a vybírat podle úlohy. Stanfordský AI Index 2026 uvádí, že rozdíl mezi nejlepšími americkými a čínskými modely byl v březnu 2026 jen 2,7 %, přestože soukromé investice do AI v USA dosáhly v roce 2025 285,9 mld. $ a v Číně 12,4 mld. $ (bez státních peněz). Evropa má Mistral a regulaci.
A jak modely umí česky? To měří vlastní testy. BenCzechMark z brněnského VUT, Masarykovy univerzity a ČVUT má 50 úloh převážně v původní češtině, třeba z testů CERMAT, recenzí z ČSFD nebo otázek z Umíme to. Hodnotí ale jen otevřené modely, protože potřebuje pravděpodobnosti jednotlivých tokenů, a ty přes API nedostanete. Uzavřené modely srovnává evropský žebříček EuroEval. V češtině se v něm k listopadu 2026 dělí o první místo GPT-6.1 sol a GPT-6 astra od OpenAI, Gemini 3.7 Flash od Googlu a otevřený GLM-5.3-Flash čínské firmy Zhipu AI; rozdíly mezi nimi jsou v mezích náhody. Nejlepší model francouzského Mistralu je až v sedmé skupině. Česká stopa je hlavně výzkumná: tým BenCzechMarku natrénoval první model zaměřený na češtinu se 7 miliardami parametrů a vlastní českou tokenizací a Jan Hajič z Univerzity Karlovy koordinuje evropský projekt OpenEuroLLM s 20 partnery, jehož první zkušební model Prelude s 9 miliardami parametrů se učí na textech v 36 jazycích. Pro praxi: na české texty vybírejte model podle českého žebříčku, ne podle anglického.
- 285,9 mld. $
- soukromé investice do AI v USA za rok 2025
- 12,4 mld. $
- soukromé investice do AI v Číně za rok 2025, bez státních
- 2,7 %
- rozdíl výkonu nejlepších modelů USA a Číny, březen 2026
- 20 $/měs
- plán Claude Pro, při roční platbě 17 $ měsíčně
Stanford AI Index 2026
Stanford AI Index 2026
Stanford AI Index 2026
claude.com/pricing, 10/2026
Králičí nory
- Arena (dříve LMArena): žebříček podle hlasování lidí ↗ · Lidé srovnávají dvě anonymní odpovědi. Nejčestnější žebříček, který existuje.
- Artificial Analysis ↗ · Výkon, rychlost a cena modelů v jednom grafu. Dobré pro výběr podle úlohy.
- Hugging Face: open-weights modely ↗ · Kde se stahují otevřené modely. Projděte si, kolik jich je.
- EuroEval: žebříček modelů v češtině ↗ · Sedm českých úloh od recenzí z ČSFD po shrnutí zpráv, otevřené i uzavřené modely v jedné tabulce.
6Text na text a prompting prakticky
0:00 / 3:26AI klon hlasu Jana Ječmínka
Dobrý prompt má sedm částí
- ·Pět tříd: text→text, text→obraz, text→video, text→zvuk, řeč→text
- ·Role a kontext · úkol · vstupní materiál · formát výstupu
- ·Příklady · omezení (délka, tón, co ne) · „pokud nevíš, řekni“
- ·Iterujte: první výstup je návrh, ne výsledek
- ·Fakta, jména a čísla kontroluje člověk. Vždy
Text na text je nejrozšířenější použití: e-maily a shrnutí, zápisy z porad, brainstorming názvů, přepis odborného textu pro jinou cílovou skupinu, strategie kampaně, analýza vložené tabulky nebo kód. Rozdíl mezi použitelným a generickým výstupem dělá prompt.
Dobrý prompt má strukturu. Role a kontext: kdo model je a pro koho pracuje („jsi copywriter klubu, píšeš rodičům dětí 6 až 10 let“). Úkol: jedna jasná věta. Vstupní materiál: fakta, data, předchozí texty; model nemá vaše know-how, dokud mu ho nedáte. Formát výstupu: délka, odrážky, tři varianty. Příklady toho, co se vám líbí (few-shot). Omezení: tón, zakázaná slova, co nevymýšlet. A pojistka: „pokud ti chybí informace, zeptej se“. U složitějších úloh nechte model, ať se nejdřív zeptá on vás.
Postup je vždy stejný: model napíše návrh, vy opravíte fakta a tón, zadáte druhou iteraci. Opakovaný kontext (brand manuál, tón hlasu, cílové skupiny) uložte do projektu v Claude nebo do vlastního GPT. Železné pravidlo: ven nejde text, který jste nečetli. Víc v návodu Anthropic, který platí i pro ostatní modely.
- -Kontrola promptu: Má roli a publikum? Má jeden jasný úkol? Dostal model fakta, která potřebuje?
- -Má formát a délku? Má příklad toho, co chcete? Má omezení (tón, zakázaná slova, co nevymýšlet)?
- -Má pojistku „pokud nevíš, zeptej se“? Zkontrolovali jste výstup proti zdroji před odesláním?
K diskuzi
Jaký je rozdíl mezi „napiš mi post“ a dobrým promptem? Vypište, co by model potřeboval vědět, aby post napsal za vás.
7Obraz: z promptu vizuál
0:00 / 2:31AI klon hlasu Jana Ječmínka
Text → obraz: za minutu moodboard, za hodinu kampaň
- ·Midjourney (estetika, styly) · GPT Image · Nano Banana · Flux · Firefly
- ·Prompt: subjekt, styl, kompozice, světlo, poměr stran, reference
- ·Konzistence značky: stejný dovětek stylu na konci každého promptu
- ·Ne na pravdivé fotky produktů. Deepfake v EU označit (od 8/2026)
Místo stock fotek nebo hodin grafika dostanete za minutu deset variant. Midjourney má nejlepší estetiku a tisíce stylů, GPT Image od OpenAI umí text v obraze a přesné úpravy, Nano Banana od Googlu drží konzistenci postavy, Flux je open-weights, Adobe Firefly je trénovaný na licencovaných datech pro případy, kdy právník chce jistotu, a Higgsfield dává víc modelů pod jednu střechu včetně videa.
Prompt pro obraz má jinou gramatiku: subjekt (kdo, co, v jaké akci), styl (fotografie, ilustrace, 3D), kompozice a objektiv (detail, širokoúhlý, z výšky), světlo (zlatá hodina, studio, neon), poměr stran podle kanálu, případně referenční obrázek. Obecný prompt dá generický obrázek, jakých je na sítích milion; přesný prompt dá vizuál z vaší kampaně. Pro značku je klíčová konzistence: jeden pevný dovětek stylu (style string) na konci každého promptu, aby obrázky vypadaly z jedné ruky.
Kde obraz z AI nepatří: na pravdivé fotky produktů (balení potravin v HOPI musí odpovídat skutečnosti), na lidi bez souhlasu a na cokoli, co se tváří jako dokument. Licence: placené plány komerční použití dovolují, přečtěte si podmínky. Od 2. srpna 2026 musíte v EU zřetelně označit deepfake, tedy realisticky vypadající obraz lidí, míst nebo událostí, které nejsou skutečné; strojový vodoznak do výstupu vkládá sám generátor. Dokončení děláte v běžných nástrojích: Photopea na úpravy, remove.bg na pozadí, Squoosh na kompresi do WebP, Adobe Express na šablony. Víc v kapitole Produkce.
Králičí nory
- mjpro.ai: styly pro Midjourney ↗ · Hotové styly a prompty. Vyberte jeden a držte se ho.
- Midjourney: dokumentace ↗ · Parametry, poměry stran, reference obrázků, plány.
- Higgsfield ↗ · Obraz, video a zvuk z více modelů v jednom rozhraní.
- Adobe Firefly ↗ · Komerčně bezpečný generátor trénovaný na licencovaných datech.
8Video, zvuk a přepis
0:00 / 3:01AI klon hlasu Jana Ječmínka
Video, hlas, hudba a přepis: nejmladší a nejrychlejší oblast
- ·Text → video: Veo, Kling, Seedance, Runway. Sekundy, ne filmy
- ·Text → zvuk: ElevenLabs (hlas), Suno a Udio (hudba), NotebookLM (podcast)
- ·Řeč → text: Whisper a přepisy v Teams. Nejméně okázalé, nejvíc použitelné
- ·Video už nelimituje technologie, ale představivost a rozpočet na iterace
Text na video je nejmladší obor a mění se po měsících: aplikace Sora od OpenAI, spuštěná na konci září 2025, v březnu 2026 oznámila konec. Veo (Google), Kling, Seedance (ByteDance), Runway nebo Pika generují klipy v řádu sekund až desítek sekund, zvládají pohyb kamery, konzistenci postavy a čím dál lepší fyziku. Z klipů se skládají reklamy, reels i celé seriály; Higgsfield má vlastní seriál generovaný od začátku do konce. Video přestává limitovat technologie a začíná limitovat představivost. A rozpočet na iterace, protože první generace málokdy sedí.
Text na zvuk: ElevenLabs dělá realistický hlas, klonování hlasu a dabing do desítek jazyků, Suno a Udio složí skladbu včetně zpěvu, NotebookLM od Googlu udělá z libovolného dokumentu podcast dvou moderátorů. V marketingu: voiceover bez studia, lokalizace videa jedním hlasem, podcast z článku, znělka bez licenčních poplatků.
Nejméně okázalá a nejvíc použitelná je řeč na text: Whisper od OpenAI (open-weights, běží i na notebooku), přepisy v Teams, automatické titulky. Přepis rozhovoru dá citace, přepis porady úkoly, přepis podcastu článek. Spojení přepis + jazykový model je pro mediální práci největší úspora času, jakou AI zatím přinesla. Jak se to potkává se streamem, je v kapitole Streaming.
Králičí nory
- Higgsfield: seriál Hell Grind ↗ · Co dnes zvládne generované video v celé epizodě.
- ElevenLabs ↗ · Hlas, klonování, dabing. Zkuste zdarma svůj hlas.
- NotebookLM ↗ · Nahrajte dokument a nechte z něj udělat podcast.
- Suno ↗ · Hudba včetně zpěvu z jednoho promptu.
9Agenti, MCP a Claude Code
0:00 / 4:39AI klon hlasu Jana Ječmínka
Od chatu k delegování
- ·Agent = model + nástroje + smyčka: plánuje, volá, vyhodnotí, pokračuje
- ·MCP (11/2024): „USB-C pro AI“, 10 000+ serverů, 97 mil. stažení měsíčně
- ·Claude Code (2025): agent přečte projekt, napíše kód, navrhne změnu
- ·Workflow s více agenty: orchestrátor, specialisté, kritik
- ·Agenti na počítači: OSWorld z 12 % na 66 % za rok (AI Index 2026)
Chat čeká na prompt a odpoví. Agent dostane cíl a pracuje: model běží ve smyčce, naplánuje kroky, zavolá nástroj (přečte soubor, spustí příkaz, vyhledá na webu, zavolá API), podívá se na výsledek a rozhodne, co dál, dokud úkol nesplní. Vy zadáváte cíl a hranice, ne kroky: z konverzace na delegování. Jak rychle to jde, ukazuje AI Index 2026: na testu OSWorld (úkoly na běžném počítači) stoupla úspěšnost agentů za rok ze zhruba 12 % na 66 %, na SWE-bench Verified (opravy chyb v reálném kódu) z 60 % k téměř 100 %.
Agent potřebuje nástroje. MCP (Model Context Protocol) je otevřený standard, který Anthropic představil 25. listopadu 2024: jednotný způsob, jak model připojit k datům a nástrojům, od Google Drive a Gmailu přes Trello po firemní databázi. Jako USB-C: jeden konektor, mnoho zařízení. V prosinci 2025 předal Anthropic MCP nadaci Agentic AI Foundation pod Linux Foundation (s OpenAI a Blockem); tehdy existovalo přes 10 000 veřejných MCP serverů a podporovaly ho ChatGPT, Gemini i Microsoft Copilot. Pro marketéra: ke svému Trellu, tabulkám nebo e-mailu připojíte model bez programátora.
Claude Code (náhled od února 2025, ostře od května 2025) je agent v terminálu nebo desktopové aplikaci: přečte celý projekt (repozitář), napíše kód, spustí testy, opraví chyby a otevře pull request, tedy návrh změny, který člověk schválí nebo vrátí. Codex od OpenAI dělá totéž. n8n a Make jsou automatizace bez kódu, kde je model jeden krok (přijde e-mail → model ho roztřídí → vznikne karta v Trellu). Dalším stupněm je workflow s více agenty: orchestrátor rozdělí práci specialistům, kritik výsledky čte a vrací. Tak vznikla i tato zahrada: třináct agentů psalo kapitoly paralelně a dva kritici je četli, jeden fakta, druhý srozumitelnost.
- 25. 11. 2024
- Anthropic představil MCP; 9. 12. 2025 ho předal Linux Foundation
- 10 000+
- veřejných MCP serverů, prosinec 2025
- 97 mil.
- stažení knihoven MCP měsíčně, prosinec 2025
- 66 %
- úspěšnost agentů na OSWorld, rok předtím ~12 %
Anthropic
Anthropic
Anthropic
Stanford AI Index 2026
K diskuzi
Co ve své práci byste delegovali agentovi hned, co až po roce a co nikdy? Proč?
Králičí nory
- Model Context Protocol: úvod ↗ · Co je server, klient a nástroj. Dvacet minut čtení.
- Claude Code: dokumentace ↗ · Jak agent v terminálu funguje a co umí.
- n8n ↗ · Automatizace bez kódu s modelem jako jedním krokem.
10Velín: AI jako síto zpráv
0:00 / 2:34AI klon hlasu Jana Ječmínka
68 e-mailů za 26 dní, užitečný jeden za tři týdny
- ·Problém: monitoring posílal všechno. Cíl: v klidném týdnu 2–3 položky
- ·Haiku vyhodí šum, Sonnet rozhodne: hned, do týdenního přehledu, nebo pryč
- ·Pravidla psaná lidsky, kalibrace na 226 označených zmínkách, palec nahoru/dolů
- ·Cena: z 0,89 na 0,25 $ denně (−72 %) díky cache a levnějšímu modelu
Velín je můj osobní přehled na jecminek.co/dashboard: zprávy, zmínky o HOPI, judu a o mně, čtivo, počasí, trhy, stav webů. Nejzajímavější část je ta, kde AI nic nepíše, jen třídí. Předtím mi monitoring médií posílal e-mail o každé zmínce: 68 e-mailů za 26 dní, užitečný jeden za dva až tři týdny. Chtěl jsem decentní doručování: v klidném týdnu dvě tři položky, raději nic než šum.
Haiku, nejlevnější třída modelů Claude, dělá síto: vyhodí zjevný šum (recepty, soutěže, jmenovce). Sonnet rozhoduje podle rubriky: 2 = upozornit hned (medaile z Grand Slamu, nehoda kamionu HOPI, majitel firmy v politice), 1 = týdenní přehled (nezávislý test výrobku), −1 = šum (krajské judo, PR článek o receptu). Rubriku jsem nenapsal od stolu: nejdřív jsem ručně označil 226 zmínek a 134 titulků (117 z nich šum) a z označení vznikla pravidla s příklady. Každá doručená položka má palec nahoru a dolů. Haiku na rozhodování nestačí (plané poplachy), proto dělá jen síto.
Cena byla druhý problém. První verze stála 0,89 $ denně a 81 % šlo na drahý Opus, který s každým dotazem dostával celá pravidla znovu, bez cache. Tři změny: pravidla a hodnocení jako dva bloky s hodinovou cache, rozhodování na Sonnetu místo Opusu (lokální test na mých označeních vyšel stejně) a noční pauza, kdy se od 22 do 6 jen sbírá a v 6:07 se roztřídí noc. Výsledek: 0,25 $ denně, o 72 % méně, při stejné kvalitě. Denní strop je 1,50 $, kdyby se něco rozbilo.
- 68
- e-mailů za 26 dní z původního monitoringu, užitečný jeden za 2–3 týdny
- 0,25 $/den
- provoz AI ve velínu po úpravách, předtím 0,89 $
- −72 %
- úspora díky hodinové cache, Sonnetu místo Opusu a noční pauze
- 226
- ručně označených zmínek, ze kterých vznikla pravidla třídění
velín
velín, rozpis útraty
velín, rozpis útraty
velín, kalibrace
Útrata velínu za modely ($ za den)
v jednotkách: $/den
Stejná kvalita třídění, 72 % nákladů pryč: hodinová cache pravidel, Sonnet místo Opusu, noc bez třídění.
data v tabulce
| před (Opus, bez cache) | 0,9 $/den | |
|---|---|---|
| po (Haiku + Sonnet, 1h cache) | 0,3 $/den |
11Co to stojí: tokeny, cache, dávky
0:00 / 3:14AI klon hlasu Jana Ječmínka
Platíte za tokeny. Výstup je 5× dražší než vstup
- ·Rozpětí 100×: 0,10 $ (Haiku 5.5) až 10 $ (Fable 5.1) za 1 mil. vstupních
- ·Cache: opakovaný začátek promptu za 2,5 až 10 % ceny
- ·Dávky (batch) do 24 h: −50 %
- ·Příklad: 1 000 dotazů denně = 11 $ na Sonnetu, 0,55 $ na Haiku
- ·Česko 11/2026: ChatGPT Plus 499 Kč s DPH, Business 410 Kč za uživatele bez DPH
API se účtuje za tokeny, zvlášť vstupní (co pošlete) a výstupní (co model napíše); výstup je pětkrát dražší, protože se generuje token po tokenu. Rozpětí cen je stonásobné. U Anthropic stojí milion vstupních tokenů 0,10 $ na Haiku 5.5, 2 $ na Sonnetu 5.5, 4 $ na Opusu 5.5 a 10 $ na Fable 5.1; výstup 0,50 až 50 $. U OpenAI je dnešní řada skoro zrcadlová: gpt-6-luna 0,10 $, gpt-6.1-sol 2 $, gpt-6-astra 10 $; starší modely „pro“ stojí i 30 $ (gpt-5.5-pro). Google účtuje Gemini Flash 0,30 až 0,75 $ a Gemini 4 Argon 2 $ (od 1. prosince 2026 už 4 $, Flash 3.6 a 3.8 od ledna 2027 dvojnásob). Ceny platí k říjnu 2026 a mění se každých pár měsíců, poměry mezi třídami zůstávají.
Kromě výběru modelu jsou dva způsoby, jak platit méně. Prompt caching: opakovaný začátek promptu (pravidla, brand manuál) se uloží do cache a při dalším volání stojí podle modelu 2,5 až 10 % ceny vstupu; zápis stojí 1,25× na pět minut nebo 2× na hodinu, vyplatí se od druhého volání. Dávky (batch): co nespěchá, pošlete najednou, dostanete do 24 hodin za polovinu. Dlouhý kontext: Anthropic účtuje celé okno 1 milionu tokenů stejnou sazbou (kromě Haiku 5.5 nad 100 tisíc), Google u modelů Pro nad 200 tisíc a OpenAI nad 272 tisíc tokenů účtují dvojnásobek.
Příklad na tabuli: 1 000 dotazů denně, každý 3 000 tokenů vstup a 500 výstup. Na Sonnetu 5.5: 3 mil. × 2 $ = 6 $ za vstup, 0,5 mil. × 10 $ = 5 $ za výstup, 11 $ denně. Když je 2 500 z 3 000 vstupních tokenů stálý prefix v cache (0,10 $ za milion), spadne celek zhruba na 6,25 $. Na Haiku 5.5 stojí totéž 0,30 $ + 0,25 $ = 0,55 $ denně. Dvacetinásobný rozdíl, proto checklist níže začíná nejlevnějším modelem. Pro jednotlivce stačí plán za 20 $ měsíčně; API, až když má něco běžet bez člověka.
Kolik stojí předplatné pro malý tým v Česku k listopadu 2026? OpenAI má pro Česko ceník v korunách včetně DPH 21 %: ChatGPT Go stojí 200 Kč měsíčně a může obsahovat reklamy, Plus 499 Kč, při roční platbě 415,83 Kč měsíčně, a nejvyšší plán Pro od 2 490 Kč. Firemní ChatGPT Business stojí 510 Kč za uživatele měsíčně, při roční platbě 410 Kč, obojí bez DPH. Anthropic uvádí ceny v dolarech bez daně a daň připočte podle fakturační adresy: Claude Pro za 20 $ tak s českou DPH vyjde na 24,20 $ měsíčně. Tarif Team pro 2 až 150 lidí stojí 25 $ za uživatele měsíčně, při roční platbě 20 $, bez DPH. Google má český ceník v korunách: Google AI Plus 149,99 Kč a Google AI Pro 549,99 Kč měsíčně; firmám nabízí Gemini v balíku Google Workspace od 14 $ za licenci měsíčně. Pětičlenný marketingový tým tak za ChatGPT Business při roční platbě zaplatí 2 050 Kč měsíčně, za Claude Team 100 $, obojí bez DPH. Rozdíl není jen v ceně: u osobních plánů ChatGPT se obsah podle ceníku používá k tréninku modelů, dokud se neodhlásíte, kdežto Claude Team a Gemini ve Workspace podle svých ceníků na firemních datech netrénují.
- 100×
- rozpětí ceny vstupního tokenu v současné řadě Anthropic i OpenAI
- 5 %
- cena cache hitu z ceny vstupu u Sonnetu a Opusu 5.5
- −50 %
- sleva za dávkové zpracování do 24 hodin
ceníky Anthropic, OpenAI, 10/2026
Anthropic, pricing
Anthropic, pricing
Cena za milion vstupních tokenů, modely Anthropic (říjen 2026)
v jednotkách: $
Haiku 5.5 je stokrát levnější než Fable 5.1; výstup stojí u všech čtyř pětkrát víc než vstup.
data v tabulce
| Haiku 5.5 | 0,1 $ | výstup 0,50 $ |
|---|---|---|
| Sonnet 5.5 | 2 $ | výstup 10 $ |
| Opus 5.5 | 4 $ | výstup 20 $ |
| Fable 5.1 | 10 $ | výstup 50 $ |
12Rizika, regulace a co bude vzácné
0:00 / 2:52AI klon hlasu Jana Ječmínka
Rizika nejsou sci-fi: jeden videohovor stál 25 mil. $
- ·Arup 2024: falešný finanční ředitel na videu, 15 převodů
- ·AI Act od 8/2026: deepfake označit, chatbot přizná, že je bot
- ·Česko: dozor ČTÚ, zákon čeká na Sněmovnu
- ·WEF do 2030: 92 mil. míst zanikne, 170 mil. vznikne
- ·Vzácné bude: důvěra, autenticita, úsudek
Rizika nejsou sci-fi. Deepfakes: finanční pracovník firmy Arup v Hongkongu se začátkem roku 2024 připojil na videohovor s „finančním ředitelem“ a kolegy, všichni byli vygenerovaní, a odeslal 200 milionů hongkongských dolarů (zhruba 25 mil. $) v 15 převodech. Pro marketéra dvě věci: značka může být zneužita k podvodu (falešný ředitel, falešná soutěž) a každé virální video je třeba ověřit (zpětné hledání v TinEye, původní zdroj) dřív, než ho sdílíte.
Informační přetížení: generování je skoro zadarmo, roste množství průměrného obsahu a klesá pozornost. Halucinace: sebejisté chyby v číslech a jménech; AI Index 2026 napočítal 362 zdokumentovaných incidentů s AI za rok, o polovinu víc než rok předtím. Soukromí: co napíšete do veřejného chatu, může sloužit k tréninku; údaje zákazníků, smlouvy a interní ceny patří jen do firemních účtů s vypnutým tréninkem, nebo nikam. Práce: Světové ekonomické fórum odhaduje do roku 2030 vznik 170 milionů míst a zánik 92 milionů; 41 % zaměstnavatelů plánuje kvůli AI snižovat stavy, rutinní kognitivní práce je první na řadě. Závislost a pozornost řeší kapitola Sociální sítě.
Regulace: EU AI Act platí od 1. srpna 2024 a nabíhá po částech. Od 2. února 2025 zákazy (manipulativní techniky, sociální skórování, rozpoznávání emocí ve škole a v práci) a povinnost AI gramotnosti ve firmách. Od 2. srpna 2025 povinnosti pro poskytovatele velkých modelů (GPAI). Od 2. srpna 2026 transparentnost: chatbot musí dát najevo, že nejste u člověka, a kdo zveřejní deepfake, musí ho zřetelně označit. Digitální omnibus (platí od 27. července 2026) odložil strojové značení výstupů u generátorů, které už byly na trhu, na 2. prosince 2026 a pravidla pro vysoce rizikové systémy (nábor, úvěry) na 2. prosince 2027. Pro marketing: označovat generovaný obsah, nemanipulovat emocemi, vést evidenci, kde AI používáte.
Jak to vypadá v Česku? AI Act je nařízení EU a platí přímo, každý stát ale musí zákonem určit, kdo ho hlídá a jak trestá. Česko takový zákon k listopadu 2026 nemá: vláda jeho návrh schválila 9. listopadu 2026 a teď ho čeká Sněmovna. Hlavním dozorovým úřadem a jednotným kontaktním místem má být Český telekomunikační úřad (ČTÚ), ve vymezených oblastech Česká národní banka a Úřad pro ochranu osobních údajů. Zákon zavádí i regulační sandbox, chráněné prostředí, kde firmy zkoušejí nové AI pod dohledem úřadu a bez hrozby pokut. ČTÚ má od září 2026 oddělení pro dohled nad AI, kontrolovat a pokutovat ale bez zákona podle vlastních slov nemůže. Poskytovatele velkých modelů hlídá přímo Evropský úřad pro AI, který jim od 2. srpna 2026 smí ukládat pokuty.
Pro agenturu je důležité, v jaké je roli. Kdo nástroj vyrábí a prodává, třeba Midjourney nebo OpenAI, je poskytovatel a jeho výstupy musí být strojově označené. Kdo AI používá v práci, je zavádějící subjekt: musí viditelně označit deepfake a text z AI, který informuje veřejnost o věcech veřejného zájmu, pokud za něj neručí redakce. ČTÚ v srpnu 2026 uvedl jako příklad štítky „AI generated“ pro obsah celý z AI a „AI modified“ pro obsah s AI upravený. Omnibus k tomu zmírnil povinnost AI gramotnosti: firmy už nemusí zajistit dostatečnou úroveň, jen podporovat vzdělávání lidí, kteří s AI pracují. A od 2. prosince 2026 bude v EU platit zákaz aplikací, které vyrábějí intimní snímky lidí bez jejich souhlasu.
Co zůstane lidem? Když text, obraz i video vyrobí kdokoli za minutu, hodnotu nemá výroba, ale to, kdo za obsahem stojí. Vzácné bude: důvěra, autenticita, charakter, kreativita z prožitku, odvaha k nepopulárnímu rozhodnutí, leadership a schopnost rozhodovat v nejistotě. Pro vaši kariéru je to důležitější otázka než to, kdy přijde obecná AI.
- 25 mil. $
- ztráta Arupu po deepfake videohovoru, 15 převodů (2024)
- 2. 8. 2026
- od kdy musí být deepfake označený a chatbot přiznat, že je bot
- 92 mil.
- pracovních míst zanikne do 2030, 170 mil. vznikne
- 362
- zdokumentovaných AI incidentů za rok, předtím 233
CNN
Evropská komise, AI Act
WEF Future of Jobs 2025
Stanford AI Index 2026

K diskuzi
Která z vašich dovedností bude za pět let vzácnější než dnes? A kterou vám AI vezme jako první?
Králičí nory
- Evropská komise: AI Act, harmonogram ↗ · Oficiální přehled, co platí od kdy, včetně odkladu z roku 2026.
- CNN (přes ABC17 News): Arup a deepfake za 25 milionů ↗ · Jak podvod probíhal krok za krokem.
- WEF: Future of Jobs Report 2025 ↗ · Která místa rostou a která mizí, podle 1 000 firem z 55 ekonomik.
- Stanford AI Index 2026: incidenty a bezpečnost ↗ · Kapitola o odpovědné AI s počty incidentů.
13AI v marketingu: kde začít zítra
0:00 / 1:47AI klon hlasu Jana Ječmínka
AI protíná všechny hodiny tohoto předmětu
- ·Copy, grafika, PPC, social, PR, data, produkce, web: všude jiný nástroj
- ·Člověk schvaluje, fakta ověřuje, značku drží
- ·Česko: AI má 95 % agentur, jasná pravidla jen 29 % malých a středních firem
- ·Rohlík, Alza, ČSOB, Seznam: AI už mluví se zákazníky
- ·Začněte jedním procesem, změřte čas, pak další
- ·Tři věty na cestu: tokeny, prompt, delegování
AI není jedna kapitola ze čtrnácti, je to vrstva přes všech třináct ostatních. V každé dělá jiný nástroj jinou práci; přehled po oborech je ve výčtu níže.
Jak AI používají čeští marketéři? Velký průzkum mezi nimi udělal Kantar v květnu 2024: z 548 marketérů z Česka a Slovenska osobně používalo jazykovou AI 92 % a obrazovou 55 %. Jen 37 % ale uvedlo, že ji jejich firma používá často nebo téměř vždy; podle nich by to mělo být 68 %. Nejvíc je brzdí obava o bezpečnost firemních dat, kterou uvedlo 79 %, pak autorská práva a osobní údaje; cena je nejslabší brzda, vadí necelé polovině. Agentury jsou dál. Ve společném průzkumu Asociace komunikačních agentur a Asociace public relations, kde od května do srpna 2024 odpovídalo 60 šéfů reklamních a PR agentur, používalo AI 95 % agentur. Skoro polovina už ji ošetřila ve smlouvách s klienty a jen 8 % kvůli ní propouštělo. Agentury s ní tvoří obsah, překládají, upravují sdělení, analyzují data a přepisují nahrávky; méně práce mají externí překladatelé, grafici, animátoři a ilustrátoři storyboardů, tedy kreslených scénářů. Letos se obraz posouvá. Podle výzkumu agenturní asociace a ResSolution Group z roku 2026 dělají zadavatelé část práce, kterou dřív posílali agenturám, s AI sami a agenturu potřebují hlavně tam, kde jim chybí expertiza. Otevřená zůstává cena: klient čeká úsporu, agentura řeší, jak si nechat zaplatit vyšší produktivitu.
Pravidla má menšina firem. V průzkumu agentury Ipsos pro Asociaci malých a středních podniků a živnostníků z února 2026, kde odpovídalo 201 majitelů a ředitelů firem do 250 zaměstnanců, mělo jasná pravidla pro používání AI jen 29 % firem: 18 % nejmenších do deseti lidí a 38 % středních. Ochranu dat většina řeší jen formálním zákazem, nebo vůbec. Přitom právě v marketingu AI v malých firmách zdomácněla nejvíc: 19 % s ní dělá grafiku v Midjourney nebo Canva AI, 15 % používá v marketingu ChatGPT a 13 % Gemini. Hlavní brzdou není odpor lidí, ale to, že nevědí jak. A publikum si AI všímá. Podle ResSolution Group z května 2026, kde odpovídalo 8 000 lidí od 15 let, potkalo v posledních měsících reklamu, kterou považuje za vytvořenou s AI, 6 z 10 Čechů. Čtyři z deseti takové reklamě věří méně než klasické, mezi lidmi od 15 do 24 let 58 %. A 56 % čeká, že značka přizná, když reklamu udělala s AI. Zákon přitom nutí označit jen deepfake, jak ukázala předchozí sekce; publikum čeká víc.
Velké české firmy posouvají AI od textů k zákazníkům. Rohlík spustil v lednu 2026 asistentku jménem Maia: v chatu navrhne jídlo, sestaví košík, upraví objednávku, a když dorazí poškozené zboží, často sama založí reklamaci a připíše kredit; na člověka se dá přepnout kdykoli. Od května jde nákup v chatu rovnou zaplatit uloženou kartou a od července má Rohlík vlastní aplikaci v ChatGPT. Uvnitř firmy na zákaznickém newsletteru dřív týden pracovalo pět lidí ze tří oddělení; dnes téma, text i obrázky připraví AI agent a člověk může do každého kroku zasáhnout, popsal v roce 2025 šéf datových a AI týmů. Rub se ukázal v říjnu 2026: útočník se dostal do nástroje zákaznické podpory a stáhl z něj část dat; podle firmy mezi nimi mohly být i chaty s virtuálním asistentem a poznámky, které si asistent o zákaznících ukládal. Alza má od září 2022 hlasového robota Alzee, který na zákaznické lince pozná důvod hovoru a přepojí ho na správný tým; dnes funguje i jako chat a od května 2026 e-shop u vybraných výrobků ukazuje souhrn recenzí z AI. ČSOB postavila asistentku Kate na velkých jazykových modelech, takže chápe souvislosti celého rozhovoru, a od dubna 2026 ji postupně dostalo skoro 500 tisíc klientů.
Seznam jde vlastní cestou. Jeho model SeLLMa vychází z otevřené Llamy 3.1 od Mety a je přetrénovaný na češtině, z akademických textů i z obsahu webů Seznamu. Asistent Seznam AI, dřív Seznam Asistent, je od května 2026 pro všechny přihlášené, na titulní stránce i ve vyhledávání, a v říjnu ho podle Seznamu týdně používaly vyšší statisíce lidí; data podle firmy zůstávají v Česku. Média si pravidla sepsala. Český rozhlas přijal pravidla pro AI v únoru 2024: transparentnost, osobní odpovědnost, bezpečnost dat a povinné posouzení rizik, než AI začne používat systematicky. V listopadu 2025 rozhlas dodal, že za obsah z AI plně odpovídá ten, kdo ji použil, posluchač se má vždy dozvědět, co vytvořila AI, a syntetický hlas nenahrazuje moderátory ani hosty a v živém vysílání ho rozhlas nepoužívá. Česká televize má od listopadu 2025 divizi pro strategický rozvoj a AI, která má sepsat i etický rámec. ČTK v dubnu 2023 uvedla, že zprávy o cenách benzinu nebo výsledcích voleb generuje ze šablon od roku 2018, každou kontroluje redaktor a v databázi zpráv nese vlastní značku; generativní nástroje podle jejích vnitřních pravidel nesmí sloužit jako zdroj informací.
Tři pravidla pro všechny obory. Člověk schvaluje: model připraví, člověk odešle. Fakta ověřuje člověk: jména, čísla, citace, odkazy. Značku drží člověk: tón, hodnoty a to, co se neříká, nejsou v promptu, pokud je tam nenapíšete. Zavádějte po jednom procesu a měřte čas před a po.
Tři věty na cestu. Model hádá další token: skvělý v jazyce, nespolehlivý ve faktech. Dobrý prompt je zadání jako pro brigádníka: role, úkol, materiál, formát, omezení. A největší změna teprve přichází: z psaní promptů na delegování cílů agentům, kteří pracují, zatímco spíte. Kdo to umí, bude v marketingu vzácný. Dnešní AI je přitom pořád úzká (ANI); kdy přijde obecná (AGI), je spor o roky i desetiletí.
- -Copywriting a značka: návrhy, varianty tónu, překlady; fakta, brand voice a identitu hlídáte vy.
- -Grafika a produkce: moodboardy, koncepty, pozadí, video; produktové fotky zůstávají pravdivé.
- -PPC a reklama: varianty textů a kreativ pro A/B testy, analýza exportu dat.
- -Social a PR v médiích: plán obsahu, přepisy, citace, tiskové zprávy; vztahy a komunita jsou vaše.
- -Data a marketing: vložit tabulku, nechat popsat, co v ní je, navrhnout segmenty a co měřit.
- -Stream, eventy, web: titulky, hlas, scénáře, kód; dramaturgie a architektura jsou vaše rozhodnutí.
- 95 %
- reklamních a PR agentur používá AI, 8 % kvůli ní propouštělo (60 šéfů agentur, 5–8/2024)
- 29 %
- malých a středních firem má jasná pravidla pro používání AI
- 56 %
- Čechů čeká, že značka přizná reklamu vytvořenou s AI
- ~500 tis.
- klientů ČSOB dostalo asistentku Kate na velkých jazykových modelech
AKA a APRA via MediaGuru, 11/2024
Ipsos pro AMSP, 2/2026
ResSolution Group via MediaGuru, 5/2026
ČSOB via E15, 6/2026

Králičí nory
- Kantar: AI v marketingové komunikaci CZ&SK (PDF) ↗ · 548 marketérů z Česka a Slovenska: kdo AI používá, co od ní čeká a co ji brzdí, zvlášť pro agentury a pro firmy. Z května 2024.
- Ipsos pro AMSP: Rok AI 2026 (PDF) ↗ · Jak AI používají malé a střední firmy: nástroje podle oddělení, pravidla, ochrana dat a bariéry, s grafy podle velikosti firmy.
Na test
Pojmy
- -Token a kontextové okno: model opakovaně předpovídá nejpravděpodobnější další token a vidí jen tolik tokenů, kolik se vejde do kontextového okna.
- -Trénink vs. inference: trénink proběhne jednou a draho, inference je každý dotaz, a po tréninku je model zmrazený, takže se z konverzace nic nenaučí.
- -Frontier vs. open-weights: frontier modely (Claude, GPT, Gemini) dostanete jen přes aplikaci nebo API, open-weights modely si stáhnete a provozujete sami.
- -Halucinace: sebejistá, ale nepravdivá odpověď, protože model optimalizuje věrohodnost, ne pravdu, takže jména, čísla a odkazy ověřujete vy.
- -Agent a MCP: agent je model ve smyčce s nástroji, který dostane cíl a pracuje sám, a MCP je otevřený standard, jak ho připojit k datům a nástrojům.
Čísla
- -2. 8. 2026: od tohoto dne musí být v EU deepfake zřetelně označený a chatbot musí dát najevo, že není člověk (AI Act, Evropská komise)
- -5×: o tolik je výstupní token dražší než vstupní, protože se generuje token po tokenu (Anthropic, ceník)
- -−50 %: sleva za dávkové zpracování (batch) s výsledkem do 24 hodin (Anthropic, ceník)
Závěrečný test je online v poslední hodině, anglicky: 30 otázek po třech možnostech z celého předmětu, na splnění je potřeba 80 %. Ptá se na pojmy z rámečků Na test a na jejich použití, podobně jako kvízy na konci hodin.
Kvíz na konec
1Trenér v chatu opraví modelu chybné jméno sportovce. Druhý den v novém okně model chybu zopakuje. Proč?
- a)Teplota byla vysoká, takže model náhodně zvolil starou verzi
- b)Model je po tréninku zmrazený a z konverzace se nic nenaučí
- c)Model se z opravy učí, ale změna se projeví až za pár týdnů
odpověď
b) Model je po tréninku zmrazený a z konverzace se nic nenaučíModel je po tréninku zmrazený a z vaší konverzace se nic nenaučí, pokud aplikace nemá zvlášť postavenou paměť (sekce 4).2Kolega zadá modelu „Napiš post o náboru do volejbalového oddílu“ a dostane obecný text, který by sedl na jakýkoli klub. Co v zadání chybělo nejvíc?
- a)Vyšší teplota, aby byl text kreativnější a méně obecný
- b)Delší kontextové okno, aby model pojal víc informací
- c)Role, publikum a fakta, která model potřebuje
odpověď
c) Role, publikum a fakta, která model potřebujeModel nemá vaše know-how, dokud mu ho nedáte, a bez role, publika a vstupních faktů vrátí generický text (sekce 6).3Klub chce nechat model třídit 1 000 zpráv denně. Každý dotaz má 2 000 vstupních a 200 výstupních tokenů. Model stojí 1 $ za milion vstupních a 5 $ za milion výstupních tokenů. Kolik klub zaplatí za den?
- a)2 $ denně
- b)3 $ denně
- c)11 $ denně
odpověď
b) 3 $ denněVstup jsou 2 mil. tokenů × 1 $ = 2 $ a výstup 0,2 mil. × 5 $ = 1 $, dohromady 3 $, protože výstup se účtuje zvlášť a dráž (sekce 11).4Úkol zní: „Zjisti, kdo z médií za poslední měsíc psal o našem klubu, a připrav tabulku.“ Čím se tu liší agent od chatu?
- a)Chat poradí postup, agent ho sám provede pomocí nástrojů
- b)Agent je chat s větším kontextovým oknem a dražším modelem
- c)Agent odpovídá rychleji, protože čerpá z vlastní databáze odpovědí
odpověď
a) Chat poradí postup, agent ho sám provede pomocí nástrojůAgent je model ve smyčce s nástroji, který dostane cíl, naplánuje kroky, volá nástroje a vyhodnocuje výsledek, dokud úkol nesplní, kdežto chat jen odpoví (sekce 9).5Agentura vygeneruje v Midjourney realistické video plného stadionu, který neexistuje, a v září 2026 ho zveřejní v reklamě v EU. Kdo má podle AI Actu jakou povinnost?
- a)Midjourney je zavádějící subjekt a video označí za agenturu, ta nemusí nic
- b)Agentura je poskytovatel, protože video vytvořila, a stačí jí vodoznak generátoru
- c)Midjourney je poskytovatel a značí strojově, agentura je zavádějící subjekt a deepfake viditelně označí
odpověď
c) Midjourney je poskytovatel a značí strojově, agentura je zavádějící subjekt a deepfake viditelně označíKdo nástroj vyrábí a prodává, je poskytovatel a jeho výstupy musí být strojově označené. Kdo AI používá v práci, je zavádějící subjekt a deepfake, tedy realisticky vypadající obraz lidí, míst nebo událostí, které nejsou skutečné, musí od 2. srpna 2026 zřetelně označit (sekce 12).
Na příště
Prezentace studenta na začátku hodiny 09 Streaming
Najděte živý přenos menšího sportu nebo akce a popište, co z něj bylo vidět: kolik kamer, grafika, komentář, kolik diváků.
5 minut, jeden student nebo dvojice, nejvýš tři slidy nebo telefon na projektoru
Zdroje, které stojí za prokliknutí
- 1Attention Is All You Need (Vaswani et al., 2017) ↗ · Článek, který zavedl Transformer. Stačí abstrakt a obrázek architektury, zbytek je pro odvážné.
- 23Blue1Brown: But what is a GPT? ↗ · Nejlepší vizuální vysvětlení tokenů, embeddingů a pozornosti, 27 minut.
- 3Andrej Karpathy: Intro to Large Language Models ↗ · Hodinová přednáška o tom, co je LLM, jak se trénuje a kam míří. Bez matematiky.
- 4Stanford HAI: AI Index Report 2026 ↗ · Každoroční souhrn čísel: adopce, investice, výkon modelů, incidenty. Primární zdroj pro většinu statistik v této kapitole.
- 5IEA: Energy and AI ↗ · Kolik elektřiny spotřebují datacentra dnes a v roce 2030. Shrnutí na jednu stránku.
- 6Anthropic: Pricing ↗ · Ceník za milion tokenů, cache, dávky, dlouhý kontext. Vzor toho, jak se AI účtuje.
- 7Anthropic: Prompt engineering overview ↗ · Oficiální návod na prompty: jasnost, příklady, role, rozklad úkolu. Platí i pro jiné modely.
- 8Model Context Protocol ↗ · Dokumentace standardu, kterým se modely připojují k datům a nástrojům. Projděte aspoň úvod.
- 9Evropská komise: AI Act ↗ · Oficiální stránka s harmonogramem: zákazy, GPAI, transparentnost od srpna 2026, vysoké riziko od prosince 2027.
- 10MIT Technology Review: kolik energie stojí dotaz v Gemini ↗ · První veřejná čísla od Googlu: 0,24 Wh, 0,26 ml vody, 0,03 g CO2 na medián dotazu.
Králičí nory
- OpenAI Tokenizer ↗ · Vložte své jméno a větu v češtině a angličtině a podívejte se, kolik tokenů to je.
- mjpro.ai: styly pro Midjourney ↗ · Tisíce ověřených stylů a promptů. Odsud beru jednotný styl pro atlasy.
- Higgsfield: seriál Hell Grind ↗ · Celý seriál generovaný AI. Ukázka, kde je video v roce 2026.
- CNN (přes ABC17 News): deepfake stál Arup 25 milionů dolarů ↗ · Videohovor s falešným finančním ředitelem a 15 převodů. Případ pro každou firemní poradu.
- Anthropic: MCP předán Linux Foundation ↗ · Jak se z interního standardu stal společný projekt Anthropicu, OpenAI a Blocku.
- Sam Altman: The Gentle Singularity ↗ · Esej šéfa OpenAI o tom, kam to míří, včetně čísla 0,34 Wh na dotaz.
- Wikipedia: ChatGPT ↗ · Přehled historie a čísel s odkazy na primární zdroje.